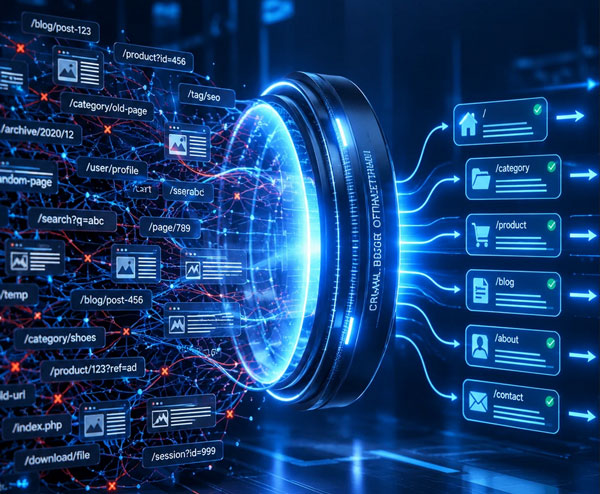
اگر گوگل بات بخش زیادی از درخواست هایش را صرف صفحه های فیلترشده، URLهای تکراری یا مسیرهای بی نتیجه کند،
ممکن است کشف و بازبینی صفحه های مهم سایت دیرتر انجام شود. این وضعیت به ویژه در فروشگاه های اینترنتی،
سایت های خبری و وب سایت هایی با آرشیوها و فیلترهای متعدد دیده می شود.
بااین حال، هر URL اضافی به معنای هدررفت جدی بودجه خزش نیست. پیش از مسدودکردن مسیرها باید مشخص کنید
گوگل دقیقاً چه URLهایی را درخواست می کند، آن ها از کجا کشف شده اند و آیا واقعاً باید خزش یا ایند به
شوند. مسدودسازی شتاب زده ممکن است دسترسی گوگل به صفحه های مهم یا منابع لازم برای رندر را هم مختل کند.
در این راهنما، دلایل خزش URLهای کم ارزش را بررسی می کنیم و راه هایی برای شناسایی و مدیریت آن ها
ارائه می دهیم؛ از اصلاح لینک های داخلی و نقشه سایت گرفته تا انتخاب درست میان ریدایرکت، حذف صفحه،
تگ noindex و دستورهای robots.txt.
منظور از URL غیرضروری چیست؟
URL غیرضروری آدرسی است که خزش مکرر آن، در مقایسه با ارزش و هدف صفحه، فایده کمی برای سایت دارد.
این تعریف به معنی بی فایده بودن همیشگی آن صفحه نیست. ممکن است یک URL برای تجربه کاربر لازم باشد،
اما نیازی نباشد در نتایج جست وجو نمایش داده شود یا مرتب توسط ربات های جست وجو بررسی شود.
نمونه های رایج عبارت اند از:
- ترکیب های متعدد فیلتر و مرتب سازی که محتوای منحصربه فردی ایجاد نمی کنند
- URLهای دارای پارامترهای رهگیری مانند پارامترهای کمپین
- صفحه های نتایج جست وجوی داخلی سایت
- نسخه های تکراری یک صفحه با تفاوت هایی مانند حروف بزرگ و کوچک یا اسلش انتهایی
- صفحه های قدیمی، خالی یا کم محتوا که دیگر پاسخ مناسبی به نیاز کاربر نمی دهند
- مسیرهای نامحدود تقویم یا صفحه بندی که تعداد زیادی URL مشابه تولید می کنند
تشخیص این که کدام URL واقعاً کم ارزش است، به هدف صفحه، رفتار کاربران، لینک های ورودی و نقش آن
در معماری سایت بستگی دارد. بنابراین، حذف یک الگوی URL بدون بررسی داده ها می تواند به صفحات مفید
نیز آسیب بزند.
خزش، ایندکس و بودجه خزش چه تفاوتی دارند؟
خزش یعنی ربات یک URL را درخواست کند و محتوای در دسترس آن را بررسی کند.
ایندکس مرحله ای جداگانه است که در آن موتور جست وجو تصمیم می گیرد محتوای صفحه را
در فهرست خود نگه دارد یا نه. بنابراین، خزیده شدن یک URL تضمین نمی کند که آن صفحه ایندکس شود.
«بودجه خزش» نیز سهمیه ای ثابت و یکسان برای همه سایت ها نیست. میزان خزش به عواملی مانند ظرفیت سرور،
سلامت پاسخ گویی سایت، اندازه و تازگی محتوا و نیاز گوگل به بازخزش وابسته است. برای بسیاری از سایت های
کوچک، مدیریت URLها همچنان مفید است، اما معمولاً نباید هر URL اضافی را به تنهایی نشانه مشکل جدی
بودجه خزش دانست.
هدف عملی، جلوگیری از تولید و کشف بی رویه URLهای کم ارزش و آسان کردن دسترسی به صفحه های مهم است؛
نه رسیدن به عددی خاص از خزش یا مسدودکردن هر صفحه ای که در نتایج جست وجو ظاهر نمی شود.
چرا گوگل URLهای غیرضروری سایت را می خزد؟
گوگل ممکن است URLی را از لینک های داخلی، نقشه سایت، لینک های خارجی یا سابقه کشف قبلی شناسایی کند.
اگر همان آدرس همچنان در دسترس باشد و نشانه روشنی برای کنارگذاشتن آن وجود نداشته باشد، ممکن است
دوباره درخواست شود. در ادامه، رایج ترین علت ها را بررسی می کنیم.
۱. لینک های داخلی به URLهای کم ارزش اشاره می کنند
هر لینکی که در منو، ف میترها، صفحه بندی، محتوای صفحه یا قالب سایت قرار می گیرد، می تواند راهی برای
کشف URLهای تازه باشد. اگر فیلترهای ترکیبی یا مرتب سازی ها لینک های قابل خزش تولید کنند، ربات ممکن
است تعداد زیادی آدرس مشابه را دنبال کند.
در این شرایط، بررسی لینک سازی داخلی و معماری مسیرهای سایت اهمیت دارد. اگر URLای نباید کشف شود،
بهتر است تا حد امکان از تولید لینک قابل خزش به آن جلوگیری کنید؛ صرفاً مسدودکردن خزش، لینک های
موجود را از سایت حذف نمی کند.
۲. فیلترها و پارامترها ترکیب های زیادی می سازند
در سایت های فروشگاهی، ترکیب رنگ، اندازه، برند، بازه قیمت و ترتیب نمایش می تواند برای یک دسته بندی
تعداد زیادی URL بسازد. پارامترهای رهگیری نیز ممکن است یک محتوای یکسان را با آدرس های متعدد در
دسترس قرار دهند. اگر این نسخه ها از طریق لینک ها قابل دسترسی باشند، گوگل ممکن است آن ها را کشف و
درخواست کند.
راه حل باید با کارکرد صفحه هماهنگ باشد: بعضی فیلترها ارزش جست وجویی دارند و باید قابل خزش باشند؛
برخی دیگر صرفاً تجربه کاربر را تغییر می دهند و بهتر است URLهای جداگانه و قابل خزش تولید نکنند.
۳. نتایج جست وجوی داخلی سایت در دسترس ربات ها قرار دارند
موتورهای جست وجوی داخلی معمولاً بر اساس هر عبارت ورودی کاربر یک صفحه اختصاصی با کدهای وضعیت ۲۰۰ می سازند. اگر این مسیرها از طریق تگ های برچسب، ماژول های «جست وجوهای پرطرفدار» یا پیوندهای متنی بدون محافظت در دسترس باشند، خزنده ها وارد هزاران صفحه با محتوای نازک یا حتی پوچ می شوند. گوگل صراحتاً در راهنماهای فنی خود تأکید می کند که صفحات نتایج جست وجوی داخلی نباید ایندکس شوند؛ زیرا هدایت کاربر از نتایج گوگل به نتایج یک جست وجوی دیگر، تجربه کاربری نامطلوبی رقم می زند.
۴. حضور URLهای باطل شده و نامعتبر در نقشه سایت (XML Sitemap)
فایل نقشه سایت یکی از مهم ترین مراجع اعلام اولویت به موتورهای جست وجو است. اگر فرآیند تولید نقشه سایت خودکار و پویا نباشد، آدرس های ریدایرکت شده، صفحات دارای وضعیت ۴۰۴، صفحات کانونیکال شده به مقصدهای دیگر یا مسیرهای پارامتری به طور مداوم به عنوان صفحات معتبر به گوگل معرفی می شوند. ارسال سیگنال متناقض (معرفی در سایت مپ و هم زمان بی ارزش بودن صفحه) خزنده ها را برای اعتبارسنجی مکرر این آدرس ها ترغیب می کند.
۵. حافظه تاریخی گوگل و پیوندهای خارجی (بک لینک ها)
ربات های جست وجو حافظه ماندگاری دارند. اگر صفحه ای در گذشته وجود داشته، اما بدون ارسال سیگنال قطعی (مانند کدهای وضعیت مناسب) در CMS غیرفعال شده باشد، گوگل تا مدت ها برای بررسی وضعیت به روزرسانی آن مراجعه می کند. علاوه بر این، چنانچه سایت های دیگر، کمپین های تبلیغاتی قدیمی یا شبکه های اجتماعی به URLهای دارای پارامترهای رهگیری یا صفحات منسوخ لینک داده باشند، خزش مجدد آن مسیرها اجتناب ناپذیر خواهد بود.
۶. ساختارهای صفحه بندی (Pagination) عمیق و غیربهینه
در آرشیوهای بزرگ، پیاده سازی غیراستاندارد صفحه بندی می تواند خزنده ها را وارد حلقه های طولانی کند. اگر ساختار پیوندها به گونه ای باشد که دسترسی به صفحات قدیمی مستلزم طی کردن صدها گام متوالی باشد یا ترکیب شماره صفحات با فیلترها کنترل نشود، بخش عمده ای از تقاضای خزش روزانه به جای محتوای تازه، صرف بازبینی صفحات انتهایی آرشیو خواهد شد.
پیامدهای خزش بی رویه URLهای کم ارزش
هدررفت منابع خزش اثرات مستقیم و غیرمستقیم متعددی بر عملکرد ارگانیک سایت دارد. درک دقیق این پیامدها به توجیه فنی تغییرات در زیرساخت وب سایت کمک می کند:
- کندی در کشف و ایندکس محتوای جدید: هنگامی که ربات زمان محدودی را در سرور سپری می کند، صرف منابع روی صفحات تکراری باعث می شود مقالات، محصولات یا به روزرسانی های جدید روزها یا هفته ها بدون بررسی باقی بمانند.
- افزایش بار پردازشی سرور و افت سرعت: پردازش درخواست های متعدد برای صفحاتی که نیاز به محاسبات سنگین دیتابیس دارند (مانند ترکیب چند فیلتر هم زمان) می تواند موجب افزایش زمان پاسخگویی سرور (Time to First Byte) و افت راندمان کلی هاست شود.
- رقیق شدن اعتبار ساختار لینک سازی (PageRank Dilution): جریان اعتبار صفحات اصلی با پخش شدن میان هزاران لینک کم ارزش یا تکراری تضعیف می شود و رتبه صفحات استراتژیک در کلمات کلیدی رقابتی آسیب می بیند.
- هم نوع خواری و افت کیفیت ایندکس: ایندکس تصادفی صفحات پارامتریک یا نتایج جست وجو می تواند منجر به رقابت صفحات داخلی با صفحات هدف (Cannibalization) و کاهش کیفیت کلی دامنه از دید الگوریتم های رتبه بندی شود.
تمایز راهبردی: عدم خزش (No-Crawl) در برابر عدم ایندکس (No-Index)
یکی از رایج ترین اشتباهات در سئو فنی، استفاده نادرست از ابزارهای کنترلی برای مدیریت صفحات کم ارزش است. تگ noindex و دستور Disallow در فایل robots.txt اهداف کاملاً متفاوتی را دنبال می کنند و ادغام نادرست آن ها مشکل را پیچیده تر می کند.
| معیار ارزیابی | دستور Disallow در Robots.txt | تگ متای Robots با مقدار Noindex | تگ کانونیکال (Rel=Canonical) |
|---|---|---|---|
| اثر بر خزش (Crawl) | مانع ارسال درخواست HTTP خزش توسط ربات می شود. | مانع خزش نمی شود؛ ربات باید صفحه را بخواند تا تگ را ببیند. | مانع خزش نمی شود؛ ربات هر دو نسخه را خزش می کند. |
| اثر بر ایندکس (Index) | تضمین کننده عدم ایندکس نیست (ممکن است بدون محتوا ایندکس شود). | صفحه را با قطعیت کامل از فهرست نتایج گوگل حذف می کند. | سیگنالی برای تجمیع اعتبار در صفحه اصلی ارائه می دهد. |
| صرفه جویی در بودجه خزش | بسیار بالا؛ درخواست به سرور ارسال نمی شود. | هیچ؛ ابتدا منابع سرور مصرف و سپس تصمیم گیری می شود. | حداقلی؛ صرفاً در بلندمدت نرخ بازخزش کاهش می یابد. |
| بهترین کاربرد | فیلترهای ترکیبی، جست وجوی داخلی، فایل های سیستمی. | صفحات فرود اختصاصی، صفحات تشکر، صفحات محتوای اختصاصی داخلی. | نسخه های بازاریابی با پارامترهای UTM، نسخه های متنی مشابه. |
یک قاعده حیاتی: اگر صفحه ای دارای تگ noindex است، هرگز نباید آن را هم زمان در فایل robots.txt مسدود کنید. با مسدودسازی دسترسی، خزنده گوگل امکان مشاهده دستور noindex را از دست می دهد و در صورت وجود لینک های خارجی یا داخلی قدیمی، ممکن است صفحه را بدون متن و صرفاً بر اساس عنوان لینک در نتایج نشان دهد.
چگونه URLهای غیرضروری در حال خزش را شناسایی کنیم؟
پیش از هرگونه تغییر فنی یا محدودسازی در دسترسی ربات ها، باید داده های واقعی را استخراج و تحلیل کنید. حدس و گمان در مورد رفتار خزنده ها ممکن است باعث مسدودسازی صفحات درآمدزا یا قطع دسترسی به منابع حیاتی رندرینگ شود. برای شناسایی دقیق این آدرس ها، سه منبع تحلیلی اصلی وجود دارد:
۱. تحلیل گزارش Crawl Stats در گوگل سرچ کنسول
بخش تنظیمات (Settings) > Crawl stats در سرچ کنسول نمایی جامع از تعداد کل درخواست های روزانه، وضعیت پاسخ های سرور و انواع فایل های دریافت شده ارائه می دهد. برای یافتن مسیرهای زاید، به این بخش ها توجه کنید:
- Crawl requests by Purpose: بررسی کنید چه درصدی از درخواست ها مربوط به Discovery (کشف آدرس های تازه) و چه میزان مربوط به Refresh (بازبینی صفحات قبلی) است. جهش ناگهانی در Discovery اغلب نشانه خزش ناخواسته صفحات فیلترشده یا پارامتریک جدید است.
- Crawl requests by Response: اگر درصد بالایی از خزش ها به وضعیت های 301/302 یا 404 ختم می شود، ربات ها در حال اتلاف درخواست روی آدرس های تغییریافته یا منسوخ هستند. در چنین مواردی اصلاح مبدأ لینک ها و استفاده از اصول تغییر مسیر ۳۰۱ ضروری است.
- گزارش Page Indexing: وضعیت هایی نظیر Crawled – currently not indexed به وضوح نشان می دهند گوگل آدرس ها را خزش کرده، اما کیفیت محتوا را برای حضور در نتایج ناکافی تشخیص داده است.
۲. بررسی فایل های لاگ سرور (Server Log Analysis)
گزارش های سرچ کنسول داده های نمونه برداری شده (Sampled) ارائه می دهند، اما لاگ های خام وب سرور واقعیت ۱۰۰ درصدی رفتار خزنده ها را ثبت می کنند. با فیلتر کردن لاگ ها بر اساس درخواست های بات های گوگل، می توانید الگوهای پرتکرار را بیابید:
- آیا ربات ها مدام ترکیب های بی پایانی از کاراکترهایی مانند
?sort=،?filter=یا?page=را بازخوانی می کنند؟ - کدام URLها با کدهای وضعیت ۲۰۰ بیشترین تعداد تقاضای روزانه را به خود اختصاص داده اند، در حالی که ترافیک ارگانیک آنها نزدیک به صفر است؟
- آیا ربات ها زمان زیادی را صرف خزش فایل های بی ارزش، اسکریپت های منسوخ یا مسیرهای پیوست رسانه می کنند؟
۳. شبیه سازی خزش با نرم افزارهای کراولر (Crawl Audit)
با ابزارهایی مانند Screaming Frog یا Sitebulb، سایت را درست شبیه به یک موتور جست وجو پیمایش کنید. این ابزارها با رسم درخت معماری سایت، موارد زیر را به سرعت آشکار می سازند:
- مسیرهایی که بیش از ۴ کلیک با صفحه اصلی فاصله دارند (عمق نامتعارف خزش).
- حلقه های تکرارشونده در فیلترها (Faceted Navigation Traps).
- تعداد لینک های داخلی ورودی (Inlinks) به صفحات با محتوای کم یا کم ارزش.
دستورالعمل گام به گام حذف URLهای کم ارزش از مسیر خزش
هنگامی که الگوهای URLهای غیرضروری را مشخص کردید، پیاده سازی راهکار باید با احتیاط و طی مراحل مهندسی شده انجام شود:
گام اول: قطع تولید و انتشار لینک در مبدأ
بزرگ ترین اشتباه این است که در قالب سایت صدها لینک به فیلترهای ترکیبی بدهید و سپس تلاش کنید با فایل robots.txt جلوی گوگل را بگیرید. نخستین اقدام، بازبینی فرانت اند است:
- لینک های فیلترهای چندگانه یا مرتب سازی را در تگ های معمولی
قرار ندهید؛ در صورت امکان از دکمه ها و تعاملات مبتنی بر JavaScript و AJAX برای بارگذاری نتایج استفاده کنید بدون اینکه URLهای مجزا در ساختار لینک ها پخش شوند. - لینک های جست وجوی داخلی را در فوتر، سایدبار یا برچسب ها قرار ندهید.
گام دوم: پاک سازی فایل های Sitemap
تمامی نقشه های سایت XML را بازبینی کنید. اطمینان حاصل نمایید که تنها URLهایی در سایت مپ قرار دارند که کدهای وضعیت ۲۰۰ دارند، کنونیکال به خود هستند (Self-referencing canonical) و هدف رتبه بندی در کلمات کلیدی هدفمند را دنبال می کنند. هیچ آدرس ریدایرکت شده، دارای پارامتر UTM، فیلتر بی ارزش یا مسدودشده در نقشه سایت نباید باقی بماند.
گام سوم: مدیریت دسترسی با Robots.txt برای الگوهای بی پایان
اگر پارامترها و الگوهای مشخصی دارید که صفحات پویا و متعددی ایجاد می کنند (مانند نتایج جست وجو یا فیلترهای چندمتغیره)، مسدودسازی با Disallow سریع ترین راه برای متوقف کردن مصرف سرور است:
User-agent: *
Disallow: /search/
Disallow: /*?*sort=
Disallow: /*?*price=
Disallow: /*&filter=
نکته فنی: پیش از بستن مسیر در فایل robots.txt، اطمینان یابید که هیچ صفحه مهمی که باید ایندکس بماند با این قواعد مطابقت ندارد.
گام چهارم: تعیین تکلیف صفحات منسوخ، حذف شده یا خطادار
اگر URLهای بدون فایده پیش تر ایجاد شده اند اما نباید به حیات خود ادامه دهند:
- اگر صفحه دارای ترافیک گذشته یا پیوندهای خارجی ارزشمند است، آن را با ریدایرکت ۳۰۱ به نزدیک ترین صفحه مرتبط والد متصل کنید.
- اگر صفحه کاملاً بی ارزش، حذف شده و بدون بک لینک است، بازگرداندن وضعیت 404 یا وضعیت سریع تر 410 (Gone) به گوگل می فهماند که این مسیر برای همیشه از دسترس خارج شده و در گذر زمان نرخ درخواست آن را به صفر می رساند.
اشتباهات متداول در مسدودسازی و حذف URLها
مدیریت مسیرهای نامطلوب اگر بدون ارزیابی جامع انجام شود، می تواند اثر معکوس بگذارد و افت ناگهانی ترافیک ارگانیک را در پی داشته باشد. رایج ترین خطاهای فنی در این زمینه عبارت اند از:
-
مسدود کردن فایل های ضروری رندر (CSS و JS):
بسیاری از وب مسترها پوشه های اسکریپت یا استایل ها را به اشتباه در robots.txt می بندند. گوگل برای درک چیدمان و پاسخ گویی موبایل نیازمند بارگذاری منابع بصری است؛ بنابراین بستن این فایل ها رندر محتوا را مختل می کند. -
تکیه صرف بر Noindex برای کنترل مصرف منابع:
تگnoindexدر بخشصفحه قرار می گیرد. خزنده ها برای دیدن این تگ باید تمام محتوا را دریافت و پردازش کنند؛ بنابراین این شیوه هیچ کمکی به بهینه سازی و ذخیره بودجه خزش نمی کند. -
ریدایرکت های زنجیره ای یا به صفحات نامرتبط:
هدایت دسته جمعی صدها آدرس پارامتری یا منقضی به صفحه اصلی (Soft 404) سیگنال منفی ایجاد می کند. اگر صفحه ای حذف شده و جایگزین مستقیم ندارد، کدهای خطای ۴۰۴ یا ۴۱۰ بسیار شفاف تر از انتقال اشتباه به صفحات نامرتبط هستند. -
ایجاد حلقه های نامحدود در صفحات آرشیو:
طراحی غیردقیق لینک های دسته بندی و شماره گذاری در آرشیوها باعث خزش تکراری و بی حاصل می شود. رعایت ساختار استاندارد در صفحه بندی سایت مانع از سرگردانی ربات ها در صفحات عمیق خواهد شد.
چک لیست مانیتورینگ و نگهداری پس از بهینه سازی
پس از اعمال محدودیت ها یا تغییر مسیرها، فرآیند مانیتورینگ نباید متوقف شود. تغییرات اعمال شده در رفتار ربات ها ظرف ۲ الی ۶ هفته در رفتار گوگل بات منعکس می شود:
| گام کنترلی | ابزار ارزیابی | نتیجه مطلوب |
|---|---|---|
| اعتبارسنجی Robots.txt | ابزار تست Robots گوگل سرچ کنسول | اطمینان از مسدود شدن دقیق URLهای هدف بدون اثر منفی بر آدرس های کلیدی. |
| پایش خطاهای Crawl Stats | Google Search Console > Settings | کاهش درصد درخواست های منجر به خطاهای سروری یا کدهای وضعیت نامطلوب و بهبود سرعت سایت. |
| وضعیت نمایه سازی (Page Indexing) | گزارش Indexing سرچ کنسول | روند کاهشی صفحات در وضعیت Discovered – currently not indexed. |
| بررسی لینک های شکسته داخلی | نرم افزارهای خزش (Screaming Frog) | صفر شدن پیوندهای داخلی به آدرس های مسدودشده یا دارای لینک های شکسته. |
سوالات متداول
آیا سایت های کوچک و نوپا هم باید نگران خزش URLهای غی رضروری باشند؟
در سایت های کوچک که کمتر از چند صد صفحه دارند، محدودیت منابع خزش دغدغه فوری نیست. با این حال، پاکیزگی ساختار URLها مانع از شکل گیری مشکلات فنی پیچیده تر، ایجاد صفحات تکراری و هم نوع خواری در زمان توسعه سایت خواهد شد
چرا گوگل با وجود Disallow در robots.txt همچنان URL را نشان می دهد؟
دستور Disallow دسترسی خزنده به محتوای صفحه را می بندد، اما مانع ایندکس آدرس بر اساس لینک های خارجی و داخلی دیگر نمی شود. برای جلوگیری قطعی از ایندکس بدون بستن دسترسی در robots.txt، باید از تگ noindex استفاده شود
چقدر طول می کشد تا گوگل پس از مسدودسازی، خزش مسیرها را متوقف کند؟
فایل robots.txt معمولاً در کمتر از ۲۴ ساعت توسط گوگل بازخوانی می شود و خزش مستقیم روی مسیرهای مسدود متوقف خواهد شد. با این حال، خروج کامل صفحات بی ارزش از گزارش های ایندکس سرچ کنسول بسته به اندازه دامنه از چند روز تا چند هفته زمان می برد